Fuentes
Guías
Aprende el oficio
Guías paso a paso sobre prompts, estilos y cómo sacar el máximo partido a la generación de imágenes con IA.
Leer las guíasComéntalo con
Elige un compañero y descubre su opinión sobre esta noticia

Elias explica la investigación detrás de los titulares en lenguaje claro.
Guías paso a paso sobre prompts, estilos y cómo sacar el máximo partido a la generación de imágenes con IA.
Leer las guíasElige un compañero y descubre su opinión sobre esta noticia
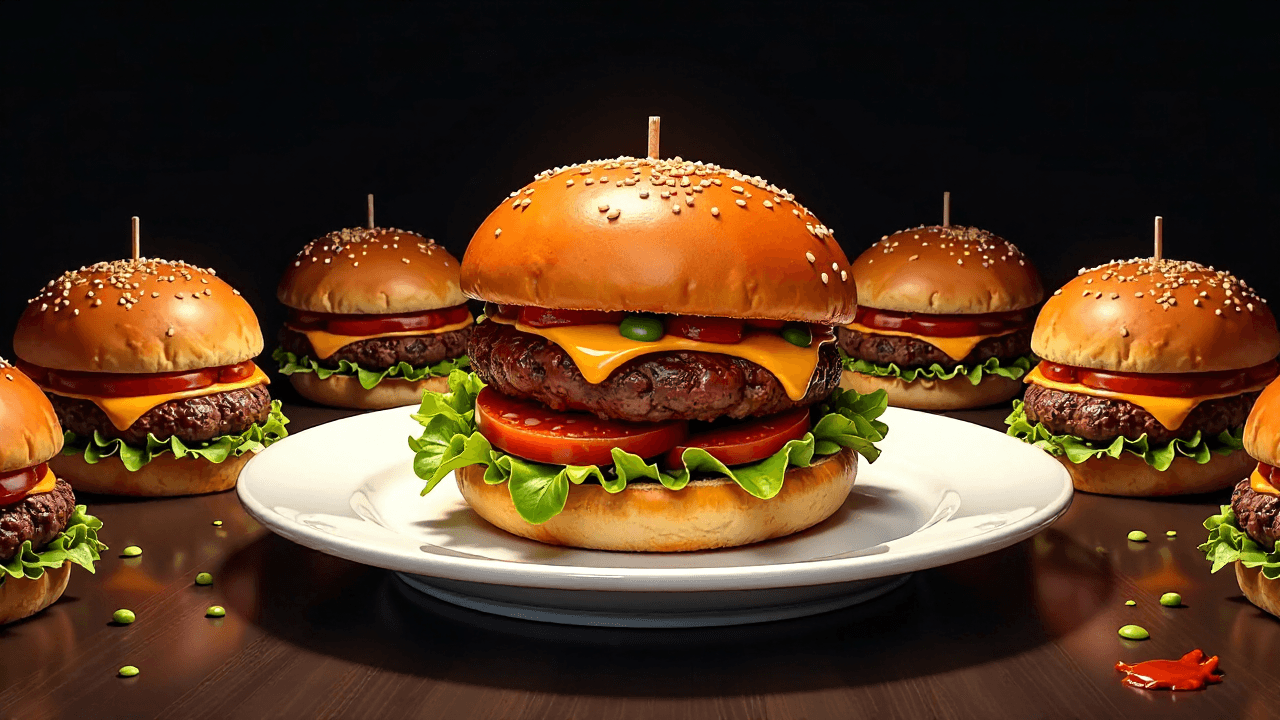
Las imágenes de comida generadas por IA se están extendiendo por los menús de restaurantes y las campañas de marca — y siguen viéndose mal de las mismas maneras específicas: desde fideos que parecen gusanos hasta helados que lucen como masilla.
El análisis en profundidad de The Verge sobre imágenes de comida con IA cataloga un desfile de horrores consistente: camarones con textura de donut, sándwiches Reuben que parecen estar descomponiéndose, fideos que se fusionan en masas únicas con forma de gusano, y pasteles con la tensión superficial de arcilla húmeda. No son errores aleatorios. Se derivan de cómo los modelos de difusión — la clase de IA que genera imágenes eliminando el ruido de forma iterativa en un campo de píxeles — aprenden cómo se ve la comida.
Los modelos de difusión se entrenan con enormes conjuntos de datos de imágenes extraídas de la web. La fotografía de comida en la web se inclina fuertemente hacia imágenes de stock idealizadas: hipersaturadas, muy retocadas y a menudo compuestas. El modelo aprende un promedio estadístico de esas imágenes, no la física de cómo un fideo mantiene su forma o cómo se derrite el helado bajo los focos del estudio. El resultado son outputs que aciertan con una paleta de colores plausible pero fallan en la lógica del material — el modelo no sabe que los camarones deben tener una translucidez específica, o que las capas de un croissant deben separarse de una manera determinada.
El problema de la contaminación cruzada agrava esto. Dado que las imágenes de comida en los conjuntos de entrenamiento suelen estar etiquetadas de forma imprecisa, la representación interna del modelo de conceptos como «cremoso» o «fibroso» puede mezclarse entre categorías. Por eso se obtiene pollo que tiene una textura fibrosa similar al papel mojado, o helado con las propiedades superficiales de la espuma de construcción.
La buena noticia para los creadores es que la mayoría de estos fallos son abordables a nivel de prompt, sin necesidad de esperar mejoras en los modelos.
El ajuste más eficaz es la especificidad de la referencia. En lugar de pedir «un bol de ramen», especifica el estilo regional («ramen tonkotsu de Hakata»), la opacidad del caldo («caldo de huesos de cerdo turbio») y el grosor de los fideos («fideos finos y rectos, textura firme»). Los modelos funcionan mejor cuando el prompt se ancla a una tradición culinaria real que los datos de entrenamiento contienen de verdad, en lugar de a una categoría genérica que se promedia entre ejemplos incompatibles.
Los descriptores de iluminación tomados de la fotografía gastronómica real — «softbox cenital difuso, ligera sombra a la izquierda» — superan a términos vagos como «profesional» o «apetecible», para los que el modelo no tiene un referente visual consistente.
Los prompts negativos importan aquí más que en la mayoría de las otras categorías de imágenes. Excluir explícitamente descriptores de textura como «surrealista», «brillante», «derretido», «sobresaturado» y «plástico» reduce los tipos de artefactos más comunes. Si tu generador admite prompts ponderados, reducir el peso del concepto de comida «perfecta» (que el modelo asocia con las fotos de stock excesivamente retocadas que causaron el problema) puede orientar los resultados hacia algo más naturalista.
Las referencias de estilo también ayudan. Orientar el prompt hacia la estética de la fotografía documental de una cocina específica — la fotografía de revistas gastronómicas japonesas tiene un estilo distintivo y bien representado en la mayoría de los conjuntos de entrenamiento — le da al modelo una distribución más estrecha de la que muestrear.
Para los creadores que construyen personajes o escenas relacionadas con la comida en el generador de imágenes de Charmloop, los mismos principios se aplican: ancla los elementos de comida a platos específicos con nombre y contextos culinarios reales, en lugar de categorías abstractas de alimentos. La sección de guías contiene tutoriales más amplios sobre técnicas de prompting que cubren la especificidad y los prompts negativos con mayor profundidad.
El problema subyacente del modelo — datos de entrenamiento que no capturan la física de los materiales — es más difícil de resolver, y requiere cambios a nivel de conjunto de datos y arquitectura que los creadores individuales no pueden controlar. Pero las soluciones a nivel de prompt son reales y utilizables hoy mismo, lo que hace que valga la pena entender la causa raíz.