Fonti
Guide
Impara l’arte
Guide passo passo su prompt, stili e su come ottenere il massimo dalla generazione di immagini con IA.
Leggi le guideParlane con
Scegli un compagno e scopri cosa ne pensa di questa storia

Elias spiega la ricerca dietro i titoli con un linguaggio chiaro.
Guide passo passo su prompt, stili e su come ottenere il massimo dalla generazione di immagini con IA.
Leggi le guideScegli un compagno e scopri cosa ne pensa di questa storia
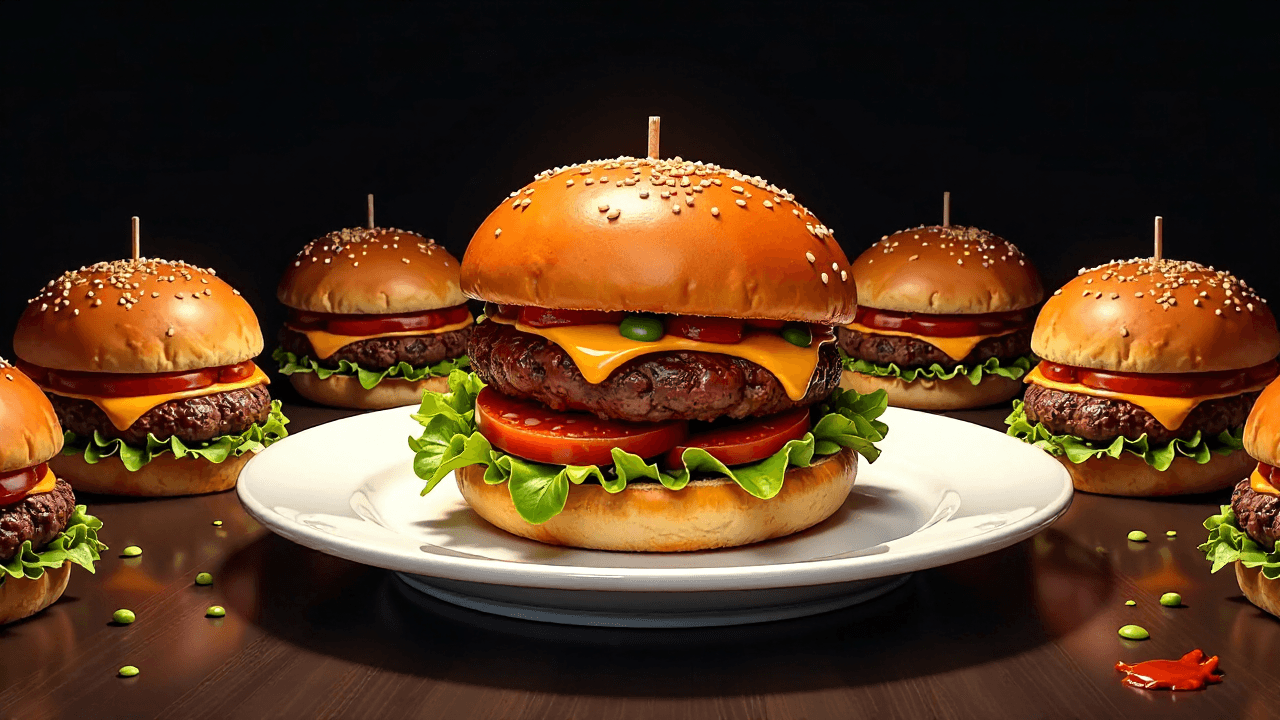
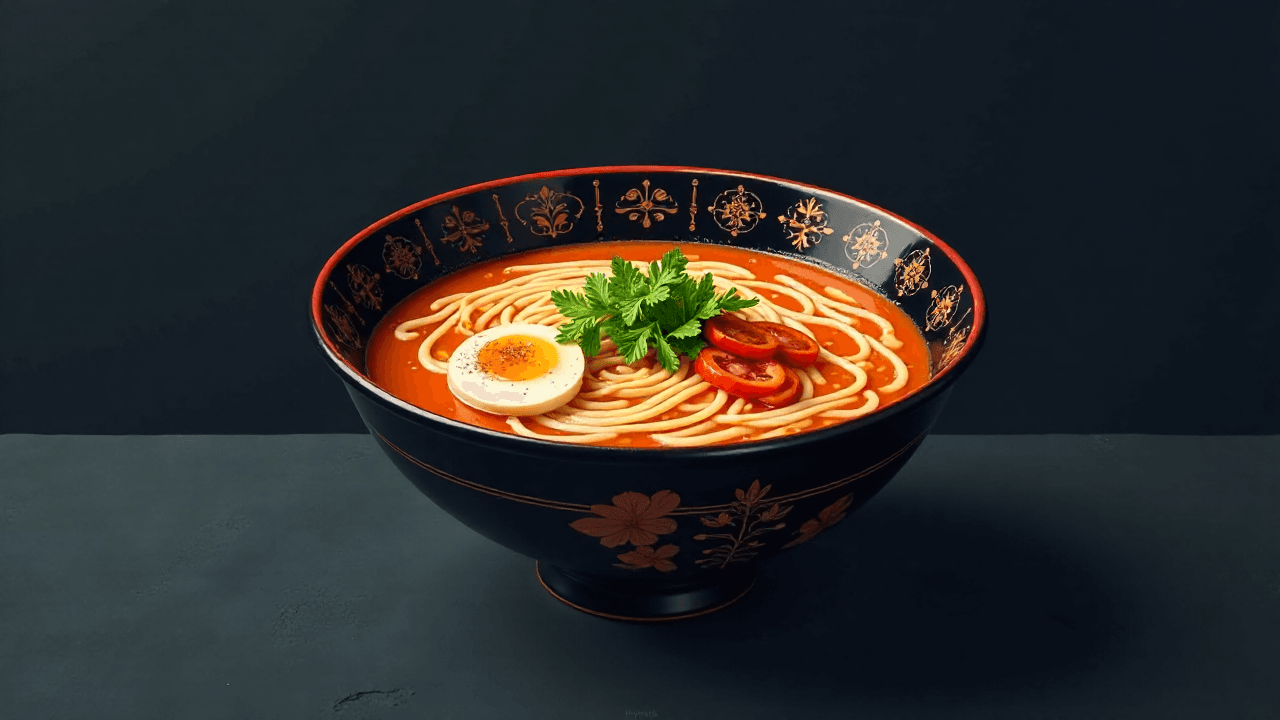
Le immagini di cibo generate dall'IA si stanno diffondendo nei menu dei ristoranti e nelle campagne dei brand — e continuano a sembrare sbagliate sempre negli stessi modi specifici: dai noodle simili a vermi al gelato che sembra stucco.
L'analisi approfondita di The Verge sulle immagini di cibo generate dall'IA cataloga un catalogo di orrori ricorrenti: gamberi con texture da donut, sandwich Reuben che sembrano in decomposizione, noodle che si fondono in masse vermiformi, e pasticcini con la tensione superficiale dell'argilla bagnata. Non si tratta di glitch casuali. Derivano dal modo in cui i modelli di diffusione — la classe di IA che genera immagini derumorando iterativamente un campo di pixel — imparano come appare il cibo.
I modelli di diffusione si addestrano su enormi dataset di immagini raccolte dal web. La fotografia gastronomica sul web è fortemente orientata verso immagini stock idealizzate: ipersaturate, pesantemente ritoccate e spesso compositate. Il modello apprende una media statistica di quelle immagini, non la fisica di come un noodle mantiene la sua forma o di come il gelato si scioglie sotto le luci da studio. Il risultato sono output che centrano una palette di colori plausibile ma falliscono sulla logica materiale — il modello non sa che i gamberi dovrebbero avere una traslucenza specifica, o che gli strati di un croissant dovrebbero separarsi in un modo particolare.
Il problema della contaminazione incrociata aggrava tutto ciò. Poiché le immagini di cibo nei dataset di addestramento sono spesso etichettate in modo approssimativo, la rappresentazione interna del modello di concetti come «cremoso» o «filante» può sconfinare tra categorie diverse. Ecco perché si ottiene del pollo che sembra fibroso come carta bagnata, o del gelato con le proprietà superficiali della schiuma da costruzione.
La buona notizia per i creator è che la maggior parte di questi difetti è risolvibile a livello di prompt, senza aspettare miglioramenti ai modelli.
L'aggiustamento più efficace in assoluto è la specificità del riferimento. Invece di chiedere «una ciotola di ramen», specificare lo stile regionale («ramen tonkotsu di Hakata»), l'opacità del brodo («brodo di ossa di maiale torbido») e il calibro dei noodle («noodle sottili e dritti, texture soda»). I modelli performano meglio quando il prompt si ancora a una tradizione culinaria reale presente nei dati di addestramento, piuttosto che a una categoria generica che viene mediata tra esempi incompatibili.
I descrittori di illuminazione presi in prestito dalla vera fotografia gastronomica — «softbox diffuso dall'alto, leggera ombra a sinistra» — superano termini vaghi come «professionale» o «appetitoso», per i quali il modello non ha un referente visivo coerente.
I prompt negativi contano qui più che nella maggior parte delle altre categorie di immagini. Escludere esplicitamente texture «surreali», «lucide», «che si sciolgono», «sovrasaturate» e «plastiche» riduce i tipi di artefatti più comuni. Se il generatore supporta il prompting ponderato, ridurre il peso del concetto di cibo «perfetto» (che il modello associa alle foto stock eccessivamente ritoccate che hanno causato il problema) può spingere i risultati verso esiti più naturalistici.
Anche i riferimenti stilistici aiutano. Orientare il prompt verso l'estetica della fotografia documentaria di una cucina specifica — la fotografia gastronomica delle riviste giapponesi ha uno stile distinto e ben rappresentato nella maggior parte dei dataset di addestramento — offre al modello una distribuzione più ristretta da cui campionare.
Per i creator che costruiscono personaggi o scene legate al cibo sul generatore di immagini di Charmloop, gli stessi principi si applicano: ancorare gli elementi gastronomici a piatti specifici con nome e contesti culinari reali, piuttosto che a categorie alimentari astratte. La sezione guide contiene approfondimenti sulle tecniche di prompting che coprono specificità e prompt negativi in modo più dettagliato.
Il problema sottostante al modello — dati di addestramento che non catturano la fisica dei materiali — è più difficile da risolvere, e richiede cambiamenti a livello di dataset e architettura che i singoli creator non possono controllare. Ma le soluzioni a livello di prompt sono reali e utilizzabili oggi, il che rende la comprensione della causa profonda uno sforzo che vale la pena fare.