Quellen
Anleitungen
Lerne das Handwerk
Schritt-für-Schritt-Anleitungen zu Prompts, Stilen und dem Maximum aus der KI-Bildgenerierung.
Anleitungen lesenDarüber sprechen mit
Wähle einen Companion und erfahre seine Meinung zu dieser Story

Elias erklärt die Forschung hinter den Schlagzeilen in klarer Sprache.
Schritt-für-Schritt-Anleitungen zu Prompts, Stilen und dem Maximum aus der KI-Bildgenerierung.
Anleitungen lesenWähle einen Companion und erfahre seine Meinung zu dieser Story
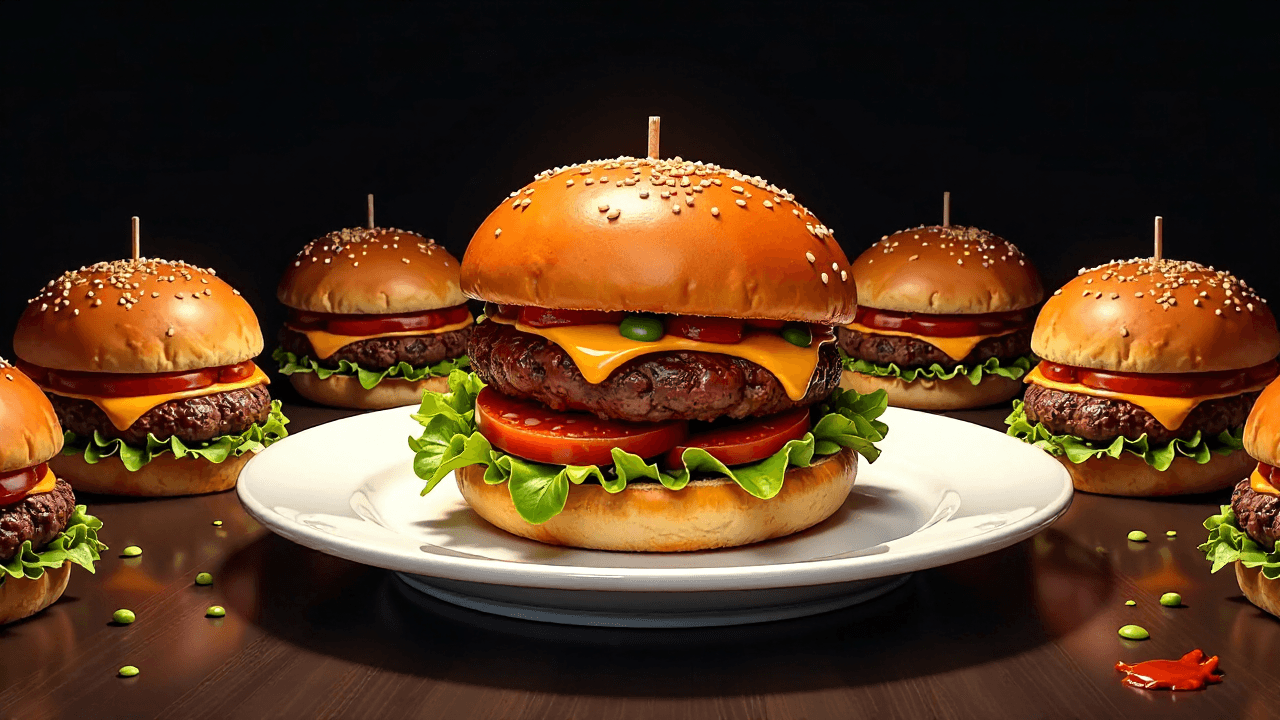
KI-generierte Lebensmittelbilder verbreiten sich auf Restaurantspeisekarten und in Markenkampagnen – und sie sehen immer wieder auf dieselben spezifischen Weisen falsch aus: von wurmartigen Nudeln bis hin zu Eis, das wie Spachtelmasse wirkt.\n\n## Die wichtigsten Erkenntnisse\n\n- KI-Bildgeneratoren scheitern bei Lebensmitteln regelmäßig, weil die Trainingsdaten überproportional aus stilisierten Stockfotos bestehen und nicht aus echten Anrichtungen – die Ergebnisse tendieren daher zu unmöglichen Texturen und Proportionen.\n- Die häufigsten Fehlerbilder sind falsche Materialeigenschaften (z. B. Garnelen mit der Textur von Donut-Teig) und Verstöße gegen die strukturelle Physik (Nudeln, die verschmelzen, Käse, der sich wie nasser Beton verhält).\n- Kunden lehnen KI-Lebensmittelbilder laut einem Bericht von The Verge häufiger ab als traditionelle Fotografie – was die vermeintlichen Kosteneinsparungen für viele Marken illusorisch macht.\n- Creators können diese Artefakte reduzieren, indem sie Prompts auf spezifische Kochtechniken, echte Gerichtsnamen und Beleuchtungssetups aus echter Lebensmittelfotografie stützen, anstatt generische Beschreibungen zu verwenden.\n- Negative Prompts gegen „glänzende", „schmelzende" und „surreale" Texturen reduzieren die häufigsten Fehlermuster in aktuellen Modellen messbar.\n\n## Die konkreten visuellen Fehler – und warum sie immer wieder auftreten\n\nDer ausführliche Bericht von The Verge über KI-Lebensmittelbilder dokumentiert eine beständige Horrorshow: Garnelen mit Donut-Teig-Textur, Reuben-Sandwiches, die zu verwesen scheinen, Nudeln, die zu einer einzigen wurmartigen Masse verschmelzen, und Gebäck mit der Oberflächenspannung von nassem Ton. Das sind keine zufälligen Fehler. Sie ergeben sich daraus, wie Diffusionsmodelle – die Klasse von KI, die Bilder durch iteratives Entrauschen eines Pixelfeldes erzeugt – lernen, wie Lebensmittel aussehen.\n\nDiffusionsmodelle werden auf riesigen Bilddatensätzen trainiert, die aus dem Web zusammengestellt wurden. Lebensmittelfotografie im Web ist stark auf idealisierte Stockbilder ausgerichtet: hypersaturiert, stark nachbearbeitet und oft composited. Das Modell erlernt einen statistischen Durchschnitt dieser Bilder, nicht die Physik, wie eine Nudel ihre Form behält oder wie Eis unter Studiolicht schmilzt. Das Ergebnis sind Ausgaben, die eine plausible Farbpalette treffen, aber bei der Materiallogik versagen – das Modell weiß nicht, dass Garnelen eine bestimmte Transluzenz haben sollten oder dass sich die Schichten eines Croissants auf eine bestimmte Weise trennen sollten.\n\nDas Kreuzkontaminationsproblem verstärkt dies noch. Da Lebensmittelbilder in Trainingsdatensätzen oft ungenau getaggt sind, kann die interne Repräsentation des Modells für „cremig" oder „faserig" über Kategorien hinweg verschwimmen. Deshalb bekommt man Hühnchen, das so faserig wirkt wie nasses Papier, oder Eis mit den Oberflächeneigenschaften von Bauschaum.\n\n## Was Prompting tatsächlich beheben kann\n\nDie gute Nachricht für Creators ist, dass die meisten dieser Fehlerbilder auf der Prompt-Ebene behebbar sind, ohne auf Modellverbesserungen warten zu müssen.\n\nDie bei weitem wirksamste Anpassung ist die Spezifität der Referenz. Statt „eine Schüssel Ramen" zu prompten, sollte man den regionalen Stil angeben („Hakata-Tonkotsu-Ramen"), die Brühenopazität („trübe Schweineknochenbouillon") und die Nudelstärke („dünne gerade Nudeln, feste Textur"). Modelle liefern bessere Ergebnisse, wenn der Prompt auf eine echte kulinarische Tradition verweist, die tatsächlich in den Trainingsdaten vorhanden ist, anstatt auf eine generische Kategorie, die über unvereinbare Beispiele hinweg gemittelt wird.\n\nBeleuchtungsbeschreibungen aus echter Lebensmittelfotografie – „diffuses Overhead-Softbox-Licht, leichter Schatten links" – übertreffen vage Begriffe wie „professionell" oder „appetitlich", für die das Modell keine konsistente visuelle Referenz hat.\n\nNegative Prompts sind hier wichtiger als in den meisten anderen Bildkategorien. Das explizite Ausschließen von „surreal", „glänzend", „schmelzend", „übersättigt" und „plastik"-Texturbeschreibungen reduziert die häufigsten Artefakttypen. Wenn der Generator gewichtetes Prompting unterstützt, kann das Herabgewichten des Konzepts „perfekter" Lebensmittelbilder – das das Modell mit den überbearbeiteten Stockfotos assoziiert, die das Problem verursacht haben – die Ergebnisse in Richtung naturalistischerer Resultate verschieben.\n\nStilreferenzen helfen ebenfalls. Das Prompten in Richtung der Ästhetik der Dokumentarfotografie einer bestimmten Küche – japanische Lebensmittelmagazinfotografie hat einen unverwechselbaren, in den meisten Trainingsdatensätzen gut repräsentierten Stil – gibt dem Modell eine engere Verteilung, aus der es samplen kann.\n\nFür Creators, die auf Charmloops Bildgenerator lebensmittelnahe Charaktere oder Szenen erstellen, gelten dieselben Prinzipien: Verankere die Lebensmittelelemente in spezifischen, benannten Gerichten und echten kulinarischen Kontexten, anstatt in abstrakten Lebensmittelkategorien. Der Guides-Bereich enthält umfassendere Walkthroughs zu Prompting-Techniken, die Spezifität und negatives Prompting ausführlicher behandeln.\n\nDas zugrundeliegende Modellproblem – Trainingsdaten, die die Materialphysik nicht erfassen – ist schwieriger zu beheben und erfordert Änderungen auf Datensatz- und Architekturebene, die einzelne Creators nicht kontrollieren können. Aber die Workarounds auf Prompt-Ebene sind real und heute nutzbar – und das macht es die Mühe wert, die Grundursache zu verstehen.