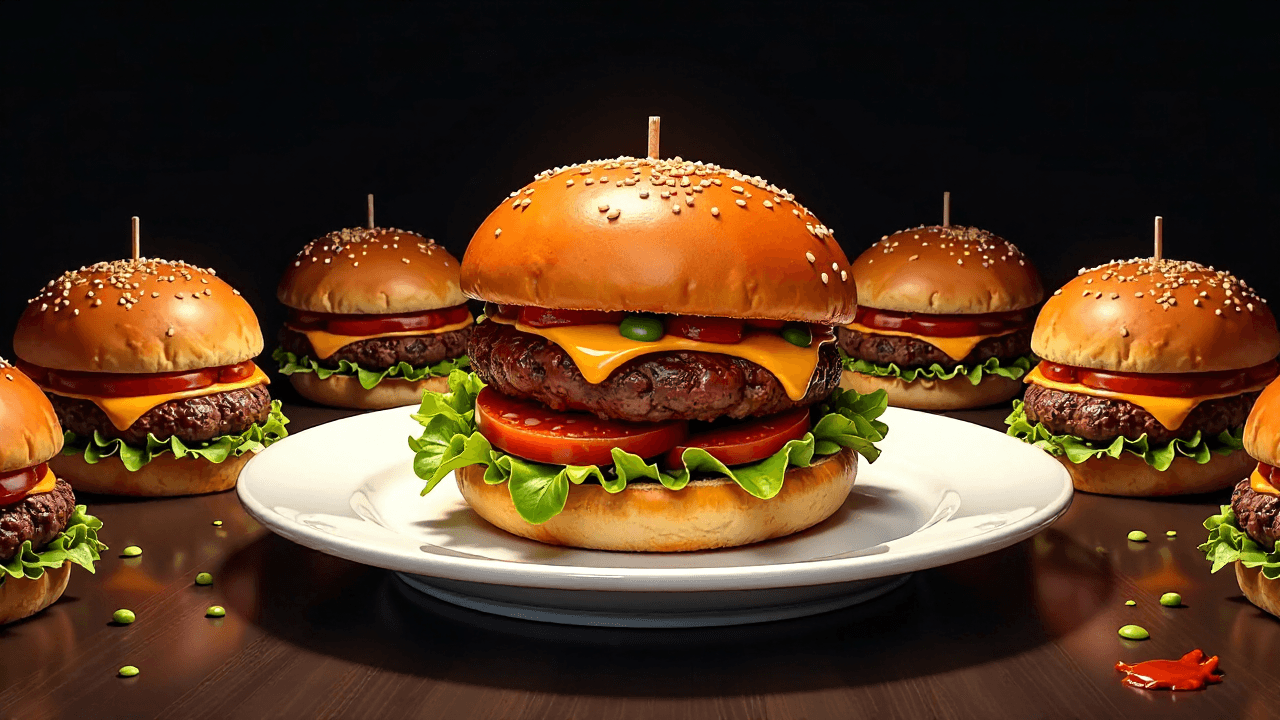
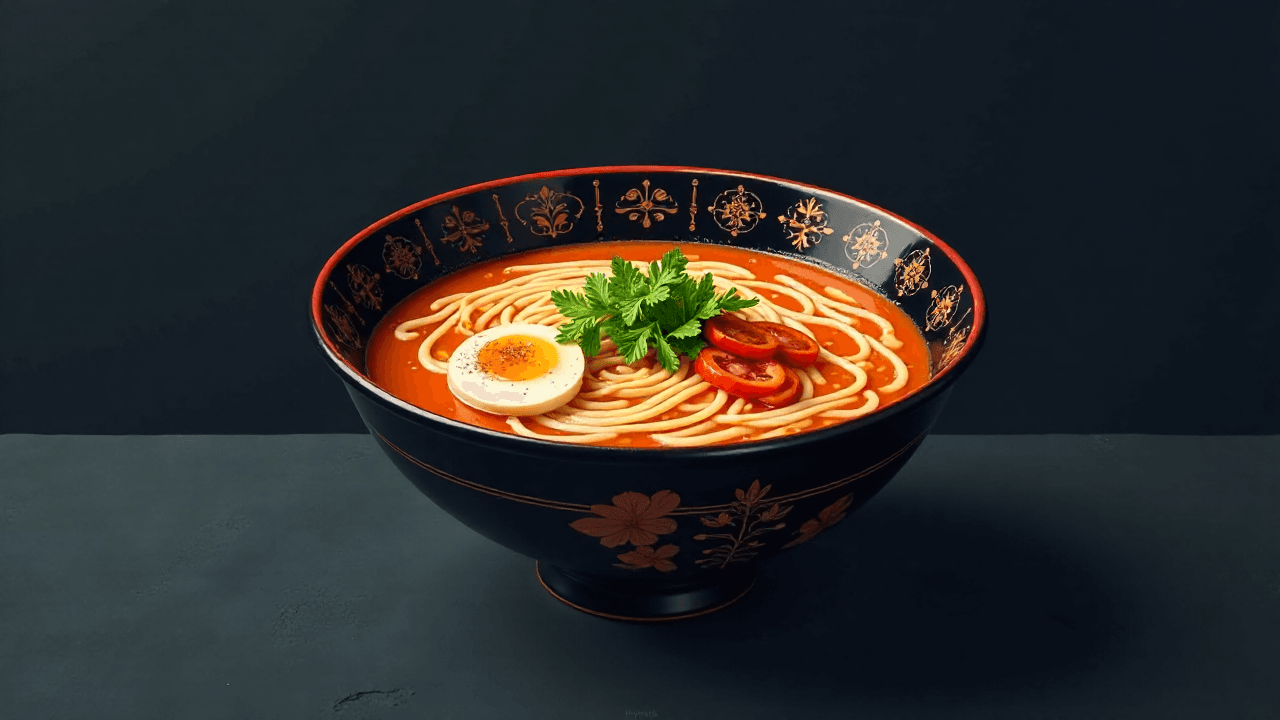
KI-generierte Foodfotografie erscheint in großem Maßstab auf Restaurantmenüs – und Kunden lehnen sie fast instinktiv ab. Diese Reaktion legt eine strukturelle Schwäche heutiger Bildgeneratoren offen, die weit über die Gastronomie hinaus relevant ist.\n\n## Die wichtigsten Erkenntnisse\n\n- Aktuelle KI-Bildgeneratoren erzeugen Food-Fotos, die hyperrealistisch, aber homogen wirken – dasselbe perfekte Glänzen, dieselbe unmögliche Beleuchtung, dasselbe zu symmetrische Anrichten bei jeder Ausgabe.\n- Menschliche Gäste spüren, dass mit KI-Food-Bildern etwas „nicht stimmt", auch wenn sie es nicht artikulieren können – so berichtet TechCrunch über die Erfahrungen der Restaurantbranche.\n- Das Gleichheitsproblem entsteht durch Verzerrungen in den Trainingsdaten: Modelle lernen, wie „gutes Essen" aussieht, anhand idealisierter Stockfotos – nicht anhand echter Restaurantgerichte mit ihren natürlichen Unvollkommenheiten.\n- Prompt-Engineering allein entkommt dieser ästhetischen Schwerkraft nicht zuverlässig – der erlernte Prior des Modells zieht die Ausgaben stets zum selben polierten Archetyp hin.\n- Für Creators ist das eine konkrete Erinnerung daran, dass hoher Fotorealismus und hohe Glaubwürdigkeit nicht dasselbe sind.\n\n## Die Trainingsdaten-Falle hinter jedem glänzenden Burger\n\nDas Kernproblem ist nicht Auflösung oder Realismus – moderne Bildgeneratoren können Food in Auflösungen erzeugen, die professionelle Fotografie übertreffen. Das Problem besteht darin, dass jedes auf Internetbildern trainierte Modell dieselbe verzerrte Stichprobe erbt: Stockfoto-Bibliotheken, Food-Magazin-Shootings und Markenkampagnen. Diese Quellen teilen eine enge Ästhetik – dramatisches Seitenlicht, extreme Makro-Fokussierung auf Texturen, Farben, die über das hinausgehen, was jede echte Küche produziert.\n\nWenn ein Restaurantbesitzer ein Modell nach „einer Schüssel Ramen" befragt, erhält er das platonische Ideal von Ramen, wie es durch zehntausend Stockfotos definiert wird – nicht die spezifische Schüssel, die sein Koch tatsächlich zubereitet. Das Ergebnis ist technisch beeindruckend und sofort als künstlich erkennbar, weil kein echtes Gericht jemals so konsistent aussieht. Das Unbehagen der Kunden ist nicht irrational; es ist Mustererkennung, die korrekt funktioniert.\n\n> „Kunden spüren instinktiv, dass mit dem Essen etwas nicht stimmt."\n>\n> — TechCrunch\n\n## Warum Prompt-Engineering hier an seine Grenzen stößt\n\nCreators, die versucht haben, darüber hinauszukommen, kennen die Frustration. Das Hinzufügen von Beschreibungen wie „unvollkommen", „natürliches Licht", „rustikal" oder „unbearbeitet" lenkt die Ausgaben in die richtige Richtung, entkommt aber selten der Schwerkraft der Trainingsverteilung. Der Prior des Modells ist stark. Ein Prompt für „leicht verwelkten Salat mit ungleichmäßigem Dressing" erzeugt immer noch etwas, das aussieht, als gehöre es in ein Michelin-Stern-Editorial.\n\nDies ist dieselbe Dynamik, die KI-generierten Content in großem Maßstab synthetisch wirken lässt – die Homogenisierung ist kein Bug eines einzelnen Modells, sondern ein Merkmal davon, wie große generative Modelle visuelle Kultur komprimieren. Die Lösung erfordert entweder Fine-Tuning auf domänenspezifischen Daten (echte Restaurantfotografie mit ihren Unvollkommenheiten) oder Referenzbild-Workflows, die die Ausgabe an einem echten Foto des tatsächlichen Gerichts verankern.\n\n## Was das für Prompting und Modellwahl bedeutet\n\nFür KI-Kunst-Creators ist der Menü-Misserfolg in der Gastronomie ein nützlicher Diagnosefall. Wenn Ihre Ausgaben auf eine einzige Ästhetik zusammenbrechen – egal wie abwechslungsreich Ihre Prompts sind – stoßen Sie wahrscheinlich an dieselbe Trainingsverteilungs-Decke. Einige konkrete Ansätze, die helfen:\n\nReferenzbilder schlagen beschreibende Adjektive. Image-to-Image- oder Style-Reference-Workflows geben dem Modell einen echten Anker außerhalb seines Trainings-Priors. Das Hochladen eines echten Fotos des Gerichts und die Bitte an das Modell, es neu zu beleuchten oder neu zu komponieren, liefert glaubwürdigere Ergebnisse als das Prompting von Grund auf.\n\nFine-tuned Modelle übertreffen Basismodelle bei Nischen-Ästhetiken. Ein LoRA oder Checkpoint, der auf einem bestimmten Food-Stil trainiert wurde – etwa Izakaya-Gerichte auf Film fotografiert – entkommt dem Stockfoto-Prior zuverlässiger als jeder Prompt, der auf ein Basismodell angewendet wird. Das Durchsuchen des Charmloop-Modellkatalogs nach domänenspezifischen Fine-Tunes ist ein schnellerer Weg als Prompt-Iteration, wenn das Basismodell gegen Sie arbeitet.\n\nFotorealismus ist das falsche Ziel. Die Restaurants, die mit KI-Bildern am besten abschneiden, sind jene, die einen stilisierten, illustrativen Look anstreben, anstatt zu versuchen, Renderings als echte Fotografie auszugeben. Kunden akzeptieren eine Zeichnung; sie lehnen ein gefälschtes Foto ab. Das kreative Ziel anzupassen – anstatt zu versuchen, das gefälschte Foto überzeugender zu machen – umgeht das Uncanny Valley vollständig.\n\nDer Charmloop-Bildgenerator unterstützt sowohl Referenzbild-Eingaben als auch Style-Transfer-Workflows – die beiden direktesten technischen Wege um das Gleichheitsproblem für Creators, die domänenspezifische Ausgaben benötigen.\n\nFür die Restaurantbranche ist die kurzfristige Antwort wahrscheinlich ein Hybrid: KI für Ideenfindung und Layout, echte Fotografie für das finale Menü. Für KI-Kunst-Creators ist die Lektion schärfer – Glaubwürdigkeit ist eine Funktion von Spezifität, und Spezifität erfordert entweder echte Referenzdaten oder ein Modell, das darauf trainiert wurde.