Bronnen
Gratis proberen
Maak ’m van jou
Geïnspireerd door dit verhaal? Maak van het idee in seconden je eigen AI-kunst — gratis beginnen, geen kaart nodig.
Gratis aan de slag

Maya benchmarkt elke nieuwe modelrelease — eerst de cijfers, nooit de hype.
Geïnspireerd door dit verhaal? Maak van het idee in seconden je eigen AI-kunst — gratis beginnen, geen kaart nodig.
Gratis aan de slagKies een companion en ontdek wat die van dit verhaal vindt
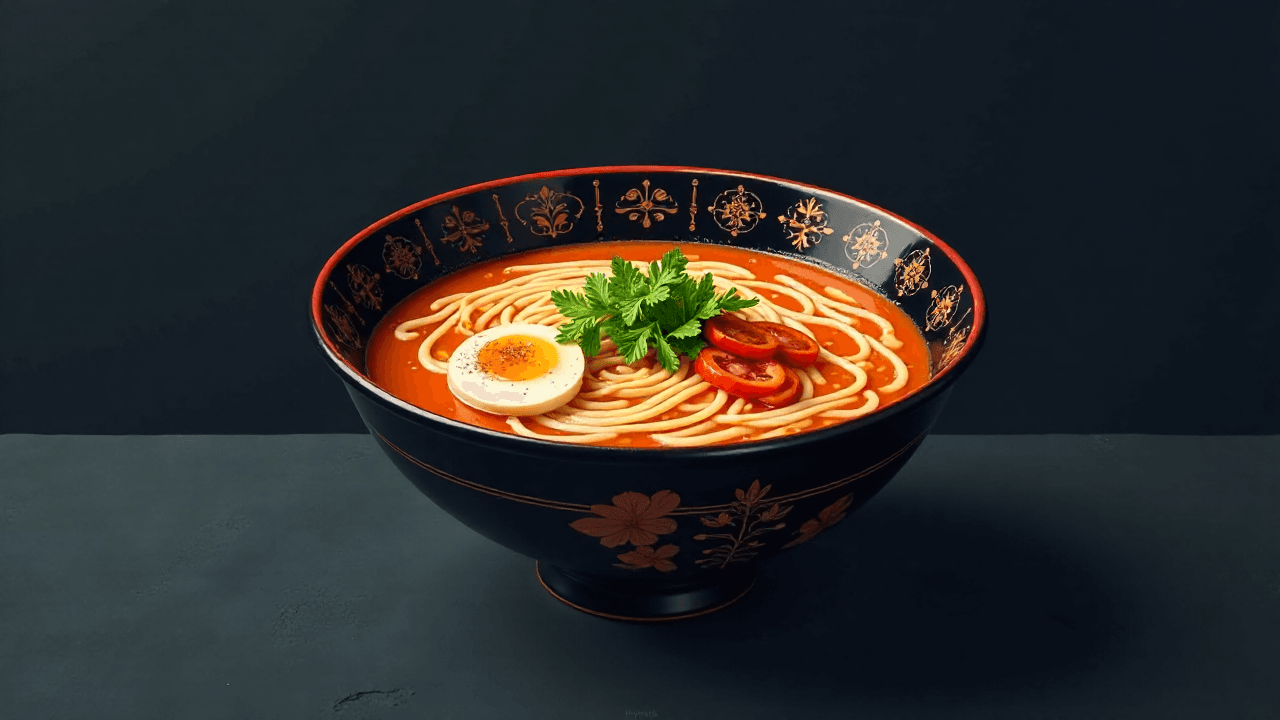
AI-gegenereerde voedselfotografie verschijnt op grote schaal op restaurantmenu's, en klanten wijzen het bijna instinctief af — een reactie die een structurele beperking in de huidige beeldgeneratoren blootlegt die ver buiten de voedingsindustrie van belang is.\n\n## Belangrijkste conclusies\n\n- Huidige AI-beeldgeneratoren produceren voedselfotos die hyperrealistisch maar homogeen zijn — dezelfde perfecte glinstering, dezelfde onmogelijke belichting, dezelfde te symmetrische presentatie in elke uitvoer.\n- Menselijke gasten kunnen voelen dat er iets „niet klopt" aan AI-voedselafbeeldingen, zelfs zonder te kunnen verwoorden waarom, aldus de berichtgeving van TechCrunch over de ervaringen in de restaurantbranche.\n- Het eenvormigheidsprobleem is het gevolg van een bias in trainingsdata: modellen leren hoe „goed eten" eruitziet op basis van geïdealiseerde stockfotografie, niet van echte restaurantgerechten met hun natuurlijke onvolkomenheden.\n- Prompt engineering alleen ontsnapt niet betrouwbaar aan deze esthetische zwaartekracht — de aangeleerde prior van het model trekt uitvoer naar hetzelfde gepolijste archetype.\n- Voor creators is dit een concrete herinnering dat hoog fotorealisme en hoge geloofwaardigheid niet dezelfde kwaliteit zijn.\n\n## De trainingsdata-val achter elke glinsterende burger\n\nHet kernprobleem is niet resolutie of realisme — moderne beeldgeneratoren kunnen voedsel produceren in resoluties die professionele fotografie overtreffen. Het probleem is dat elk model dat op internetafbeeldingen is getraind, hetzelfde vertekende sample erft: stockfotobibliotheken, shoots voor voedingstijdschriften en merkcampagnes. Deze bronnen delen een smalle esthetiek — dramatische zijbelichting, extreem macrofocus op textuur, kleuren die verder zijn opgedreven dan welke echte keuken ook produceert.\n\nWanneer een restauranteigenaar een model vraagt om „een kom ramen", krijgt hij het platonische ideaal van ramen zoals gedefinieerd door tienduizend stockfoto's, niet de specifieke kom die zijn chef daadwerkelijk maakt. Het resultaat is technisch indrukwekkend en onmiddellijk herkenbaar als kunstmatig, omdat geen enkel echt gerecht er ooit zo consistent uitziet. Het ongemak van klanten is niet irrationeel; het is patroonherkenning die correct werkt.\n\n> „Klanten kunnen visceraal aanvoelen dat er iets mis is met het eten."\n>\n> — TechCrunch\n\n## Waarom prompt engineering hier een plafond bereikt\n\nCreators die hebben geprobeerd dit te doorbreken, kennen de frustratie. Het toevoegen van beschrijvingen als „onvolmaakt", „natuurlijke belichting", „rustiek" of „onbewerkt" stuurt de uitvoer in de goede richting, maar ontsnapt zelden aan de zwaartekracht van de trainingsdistributie. De prior van het model is sterk. Een prompt voor „een licht verwelkte salade met ongelijkmatige dressing" produceert nog steeds iets dat eruitziet alsof het thuishoort in een Michelin-ster editorial.\n\nDit is dezelfde dynamiek die AI-gegenereerde content op grote schaal synthetisch laat aanvoelen — de homogenisering is geen bug in een enkel model, het is een kenmerk van hoe grote generatieve modellen de visuele cultuur comprimeren. De oplossing vereist ofwel fine-tuning op domeinspecifieke data (echte restaurantfotografie, met de onvolkomenheden intact) of referentieafbeelding-workflows die de uitvoer verankeren aan een echte foto van het daadwerkelijke gerecht.\n\n## Wat dit betekent voor prompting en modelkeuze\n\nVoor AI-kunstcreators is het mislukte geval van het restaurantmenu een nuttige diagnose. Als uw uitvoer naar één enkele esthetiek convergeert — hoe gevarieerd uw prompts ook zijn — stuit u waarschijnlijk op hetzelfde trainingsdistributieplafond. Een paar concrete benaderingen die helpen:\n\nReferentieafbeeldingen verslaan beschrijvende bijvoeglijke naamwoorden. Image-to-image- of stijlreferentie-workflows geven het model een echte anker buiten zijn trainings-prior. Het uploaden van een echte foto van het gerecht en het model vragen het opnieuw te belichten of te hercomponeren, levert geloofwaardigere resultaten op dan vanaf nul prompts invoeren.\n\nFine-tuned modellen presteren beter dan basismodellen voor niche-esthetiek. Een LoRA of checkpoint getraind op een specifieke voedselstijl — bijvoorbeeld izakaya-gerechten gefotografeerd op film — ontsnapt betrouwbaarder aan de stockfoto-prior dan welke prompt ook die op een basismodel wordt toegepast. Bladeren door de Charmloop-modelcatalogus voor domeinspecifieke fine-tunes is een snellere weg dan prompt-iteratie wanneer het basismodel u tegenwerkt.\n\nFotorealisme is het verkeerde doel. De restaurants die het beste presteren met AI-beeldmateriaal zijn degenen die kiezen voor een gestileerde, illustratieve look in plaats van renders te proberen door te laten gaan als echte fotografie. Klanten accepteren een tekening; ze wijzen een neppe foto af. Het creatieve doel aanpassen — in plaats van proberen de neppe foto overtuigender te maken — omzeilt de uncanny valley volledig.\n\nDe Charmloop-beeldgenerator ondersteunt zowel referentieafbeelding-invoer als stijloverdracht-workflows, de twee meest directe technische routes rond het eenvormigheidsprobleem voor creators die domeinspecifieke uitvoer nodig hebben.\n\nVoor de restaurantbranche is het kortetermijnantwoord waarschijnlijk een hybride aanpak: AI voor ideevorming en lay-out, echte fotografie voor het definitieve menu. Voor AI-kunstcreators is de les scherper — geloofwaardigheid is een functie van specificiteit, en specificiteit vereist ofwel echte referentiedata of een model dat daarop is getraind.