Źródła
Wypróbuj za darmo
Zrób to po swojemu
Zainspirowała Cię ta historia? Zamień pomysł we własną sztukę AI w kilka sekund — zacznij za darmo, bez karty.
Zacznij za darmo

Maya benchmarkuje każdą premierę modelu — najpierw liczby, nigdy hype.
Zainspirowała Cię ta historia? Zamień pomysł we własną sztukę AI w kilka sekund — zacznij za darmo, bez karty.
Zacznij za darmoWybierz towarzysza i poznaj jego zdanie na temat tej historii
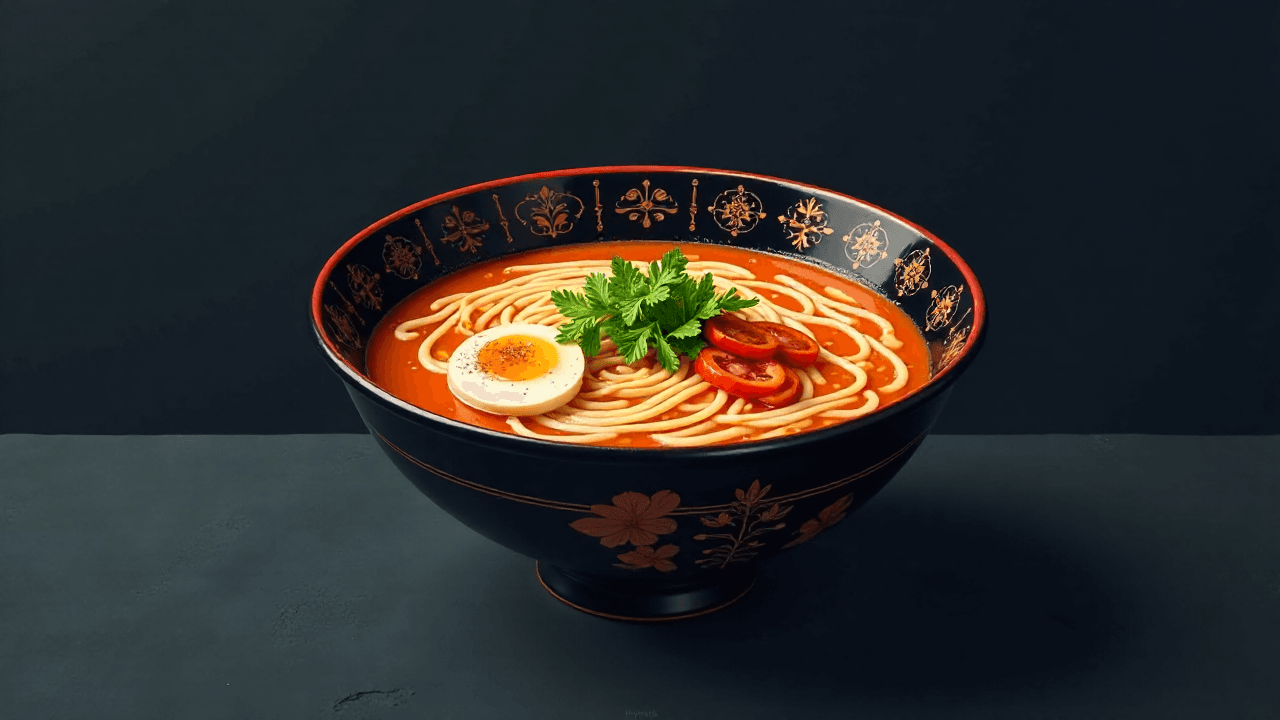
Fotografia kulinarna generowana przez AI pojawia się w menu restauracji na masową skalę, a klienci odrzucają ją niemal instynktownie — reakcja ta odsłania strukturalne ograniczenie dzisiejszych generatorów obrazów, które ma znaczenie daleko wykraczające poza branżę gastronomiczną.\n\n## Najważniejsze wnioski\n\n- Obecne generatory obrazów AI produkują zdjęcia jedzenia, które wyglądają hiperrealistycznie, lecz jednorodnie — ta sama idealna połyskliwość, to samo niemożliwe oświetlenie, ta sama zbyt symetryczna prezentacja w każdym wygenerowanym obrazie.\n- Jedzący potrafią wyczuć, że coś jest „nie tak" ze zdjęciami jedzenia z AI, nawet jeśli nie są w stanie tego zwerbalizować — wynika to z doniesień TechCrunch na temat doświadczeń branży restauracyjnej.\n- Problem jednolitości wynika ze stronniczości danych treningowych: modele uczą się, jak wygląda „dobre jedzenie", na podstawie wyidealizowanych zdjęć stockowych, a nie rzeczywistych dań restauracyjnych z ich naturalnymi niedoskonałościami.\n- Sam prompt engineering nie pozwala niezawodnie uciec od tej estetycznej grawitacji — wyuczony prior modelu przyciąga wyniki ku temu samemu wygładzonemu archetypowi.\n- Dla twórców to konkretne przypomnienie, że wysoki fotorealizm i wysoka wiarygodność to nie ta sama jakość.\n\n## Pułapka danych treningowych kryjąca się za każdym połyskującym burgerem\n\nPodstawowy problem nie leży w rozdzielczości ani realizmie — nowoczesne generatory obrazów potrafią tworzyć zdjęcia jedzenia w rozdzielczościach przewyższających profesjonalną fotografię. Problem polega na tym, że każdy model trenowany na danych z internetu dziedziczy tę samą wypaczoną próbkę: biblioteki zdjęć stockowych, sesje dla magazynów kulinarnych i kampanie reklamowe marek. Źródła te łączy wąska estetyka — dramatyczne boczne oświetlenie, skrajne makro skupione na teksturze, kolory podbite ponad to, co wytwarza jakakolwiek prawdziwa kuchnia.\n\nKiedy właściciel restauracji prosi model o „miskę ramenu", otrzymuje platoński ideał ramenu zdefiniowany przez dziesięć tysięcy zdjęć stockowych — nie konkretną miskę, którą faktycznie przygotowuje jego kucharz. Wynik jest technicznie imponujący i natychmiast rozpoznawalny jako sztuczny, bo żadne prawdziwe danie nigdy nie wygląda tak spójnie. Dyskomfort klientów nie jest irracjonalny — to rozpoznawanie wzorców działające prawidłowo.\n\n> „Klienci dosłownie czują, że coś jest nie tak z tym jedzeniem."\n>\n> — TechCrunch\n\n## Dlaczego prompt engineering napotyka tu sufit\n\nTwórcy, którzy próbowali przebić się przez tę barierę, znają tę frustrację. Dodawanie deskryptorów takich jak „niedoskonałe", „naturalne oświetlenie", „rustykalne" czy „nieretuszowane" przesuwa wyniki we właściwym kierunku, ale rzadko pozwala uciec od grawitacyjnego przyciągania rozkładu treningowego. Prior modelu jest silny. Prompt o „lekko zwiędłej sałatce z nierównomiernie rozłożonym dressingiem" nadal daje coś, co wygląda jak zdjęcie z editorialu restauracji z gwiazdką Michelin.\n\nTo ta sama dynamika, która sprawia, że treści generowane przez AI wydają się syntetyczne w skali — homogenizacja nie jest błędem żadnego pojedynczego modelu, lecz cechą sposobu, w jaki duże modele generatywne kompresują kulturę wizualną. Rozwiązanie wymaga albo fine-tuningu na danych specyficznych dla danej domeny (rzeczywistej fotografii restauracyjnej z zachowanymi niedoskonałościami), albo przepływów pracy opartych na obrazach referencyjnych, które zakotwiczają wynik w prawdziwym zdjęciu konkretnego dania.\n\n## Co to oznacza dla promptowania i wyboru modelu\n\nDla twórców AI-artu przypadek nieudanego menu restauracyjnego jest użytecznym testem diagnostycznym. Jeśli twoje wyniki zapadają się w kierunku jednej estetyki — bez względu na to, jak zróżnicowane są twoje prompty — prawdopodobnie uderzasz w ten sam sufit rozkładu treningowego. Kilka konkretnych podejść, które pomagają:\n\nObrazy referencyjne biją opisowe przymiotniki. Przepływy pracy image-to-image lub style-reference dają modelowi prawdziwą kotwicę poza jego treningowym priorem. Wgranie rzeczywistego zdjęcia dania i poproszenie modelu o zmianę oświetlenia lub rekomponowanie daje bardziej wiarygodne wyniki niż promptowanie od zera.\n\nFine-tuned modele przewyższają modele bazowe w niszowych estetykach. LoRA lub checkpoint wytrenowany na konkretnym stylu kulinarnym — powiedzmy, daniach izakaya fotografowanych na filmie — pozwoli niezawodniej uciec od prioru zdjęć stockowych niż jakikolwiek prompt zastosowany do modelu bazowego. Przeglądanie katalogu modeli Charmloop w poszukiwaniu fine-tunów specyficznych dla danej domeny to szybsza droga niż iterowanie promptów, gdy model bazowy stawia opór.\n\nFotorealizm to zły cel. Restauracje, którym najlepiej wychodzi AI-imagery, to te, które skłaniają się ku stylizowanemu, ilustracyjnemu wyglądowi, zamiast próbować podawać rendery za prawdziwą fotografię. Klienci akceptują rysunek; odrzucają fałszywe zdjęcie. Zmiana celu twórczego — zamiast prób uczynienia fałszywego zdjęcia bardziej przekonującym — całkowicie omija dolinę niesamowitości.\n\nGenerator obrazów Charmloop obsługuje zarówno wprowadzanie obrazów referencyjnych, jak i przepływy pracy style-transfer, które są dwoma najbardziej bezpośrednimi technicznymi drogami wokół problemu jednolitości dla twórców potrzebujących wyników specyficznych dla danej domeny.\n\nDla branży restauracyjnej krótkoterminową odpowiedzią jest prawdopodobnie podejście hybrydowe: AI do ideacji i układu, rzeczywista fotografia do finalnego menu. Dla twórców AI-artu lekcja jest ostrzejsza — wiarygodność jest funkcją specyficzności, a specyficzność wymaga albo prawdziwych danych referencyjnych, albo modelu, który był na nich trenowany.